ECHO Analyze

ECHO Analyze는 웨이브그램의 머신러닝 플랫폼입니다. 생산 · 설비 · 품질 · 판매 데이터로 AI 모델을 만들고 검증해 수요 · 불량 · 고장을 미리 예측하고, 목표에 맞는 최적 조건을 찾습니다. 만든 모델은 MES, 대시보드, 오케스트레이터가 바로 불러 씁니다.

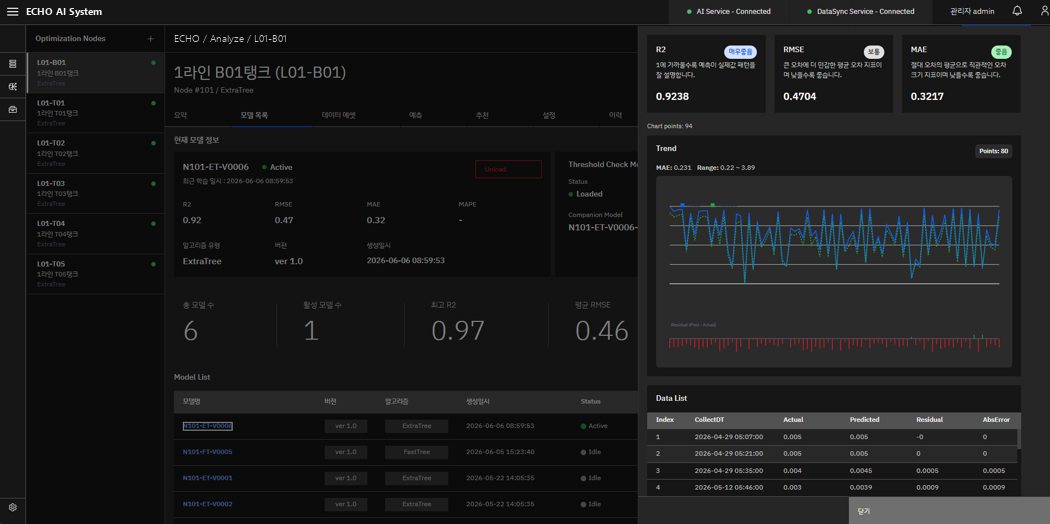
실제 구축 현장의 품질 예측 정확도
R² 0.92
한 플랫폼에서 함께
예측 + 최적화
모델 개발 전 과정을 한곳에서
데이터 → 배포
업무 시스템 어디서나 호출
API 한 줄
주요 이점

결과가 나오기 전에 아세요

수요, 불량, 품질, 고장처럼 아직 일어나지 않은 결과를 지금 데이터로 미리 계산합니다.
목표에 맞는 답을 받으세요

원하는 결과와 바꿀 수 있는 범위를 넣으면 가장 가까운 조건 후보와 예상 결과를 돌려줍니다.

만든 모델을 어디서나 쓰세요

검증한 모델은 API로 배포되어 MES, 대시보드, 오케스트레이터가 같은 모델을 함께 씁니다.

모델을 계속 믿을 수 있게

운영 중에도 예측과 실제를 비교해 성능이 떨어지면 알리고, 다시 학습한 모델로 바꿉니다.

누가 쓰나

분석 전담 인력이 없어도 시작하세요

데이터 담당자

예측 대상과 학습 자료를 정합니다. 모델별 평가 결과를 비교해 적용할 모델을 고릅니다.

생산·품질 관리자

생산 조건과 검사값의 관계를 살펴봅니다. 예측 결과를 공정 점검과 품질 판단의 자료로 씁니다.

설비 관리자

설비 값의 평소 패턴과 변화 구간을 대조합니다. 점검 대상과 정비 순서를 정하는 데 분석 결과를 활용합니다.

기능

데이터 준비부터 배포까지 한곳에서 끝내세요

01

데이터를 학습할 수 있게 준비하세요

흩어진 설비 · 생산 · 품질 데이터를 시간과 기준에 맞춰 합치고, 빈 값과 틀린 값을 품질 점수로 먼저 보여 줍니다.

02

여러 모델을 자동으로 비교하세요

같은 데이터로 여러 머신러닝 모델을 학습시키고 같은 합격 기준(R² · 오차 등)으로 비교해 가장 잘 맞는 모델을 고릅니다.

03

예측 모델을 바로 만드세요

수치 예측, 양 · 불 분류, 이상 탐지, 시계열 예측까지 문제에 맞는 모델을 같은 화면에서 만듭니다.

04

최적 조건을 계산하세요

목표 결과를 넣으면 모델을 거꾸로 써서 조건 후보와 후보별 예상 결과를 계산합니다. 바꾸기 전에 시뮬레이터로 먼저 돌려 봅니다.

05

API로 배포하세요

검증한 모델을 버튼 한 번으로 배포합니다. 업무 시스템과 AI 에이전트는 API 한 줄로 예측을 불러 씁니다.

06

배포한 뒤에도 관리하세요

모델 버전, 학습 데이터, 평가 결과를 이력으로 남기고, 운영 중 성능을 감시해 재학습 시점을 알려 줍니다.

화면

학습과 평가를 화면에서 확인하세요

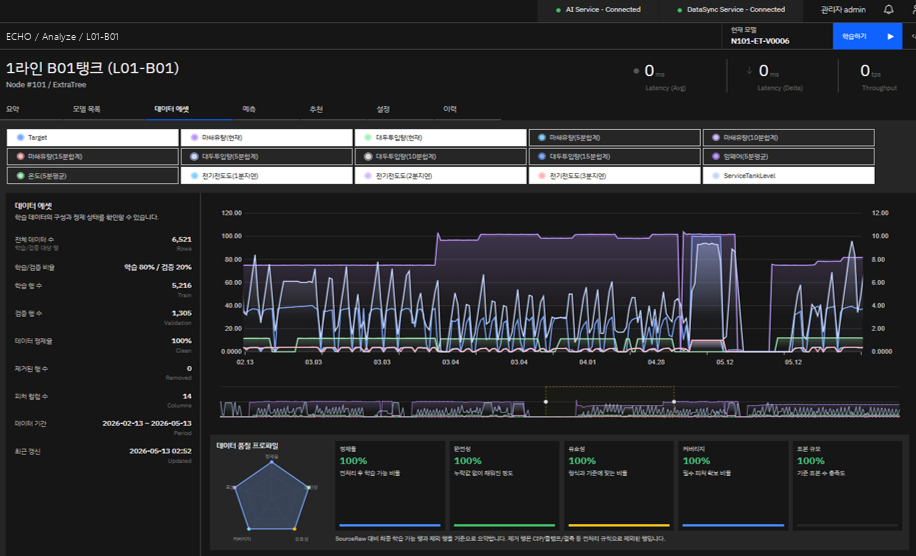
화면 1 · 데이터 수, 학습·검증 비율, 센서별 추이, 데이터 품질 프로파일

학습 데이터 한눈에

실제 구축 화면입니다. 학습에 쓸 데이터가 몇 건인지, 비어 있거나 틀린 값은 없는지 그래프와 품질 점수로 먼저 확인합니다.
  • 데이터 구성
  • 센서 추이
  • 품질 점수
ECHO Analyze · 데이터 에셋
ECHO Analyze 데이터 에셋 화면. 학습 데이터 6,521행의 구성과 정제 상태, 센서별 추이, 데이터 품질 프로파일
사용 사례

이런 문제를 Analyze로 풉니다

품질 예측

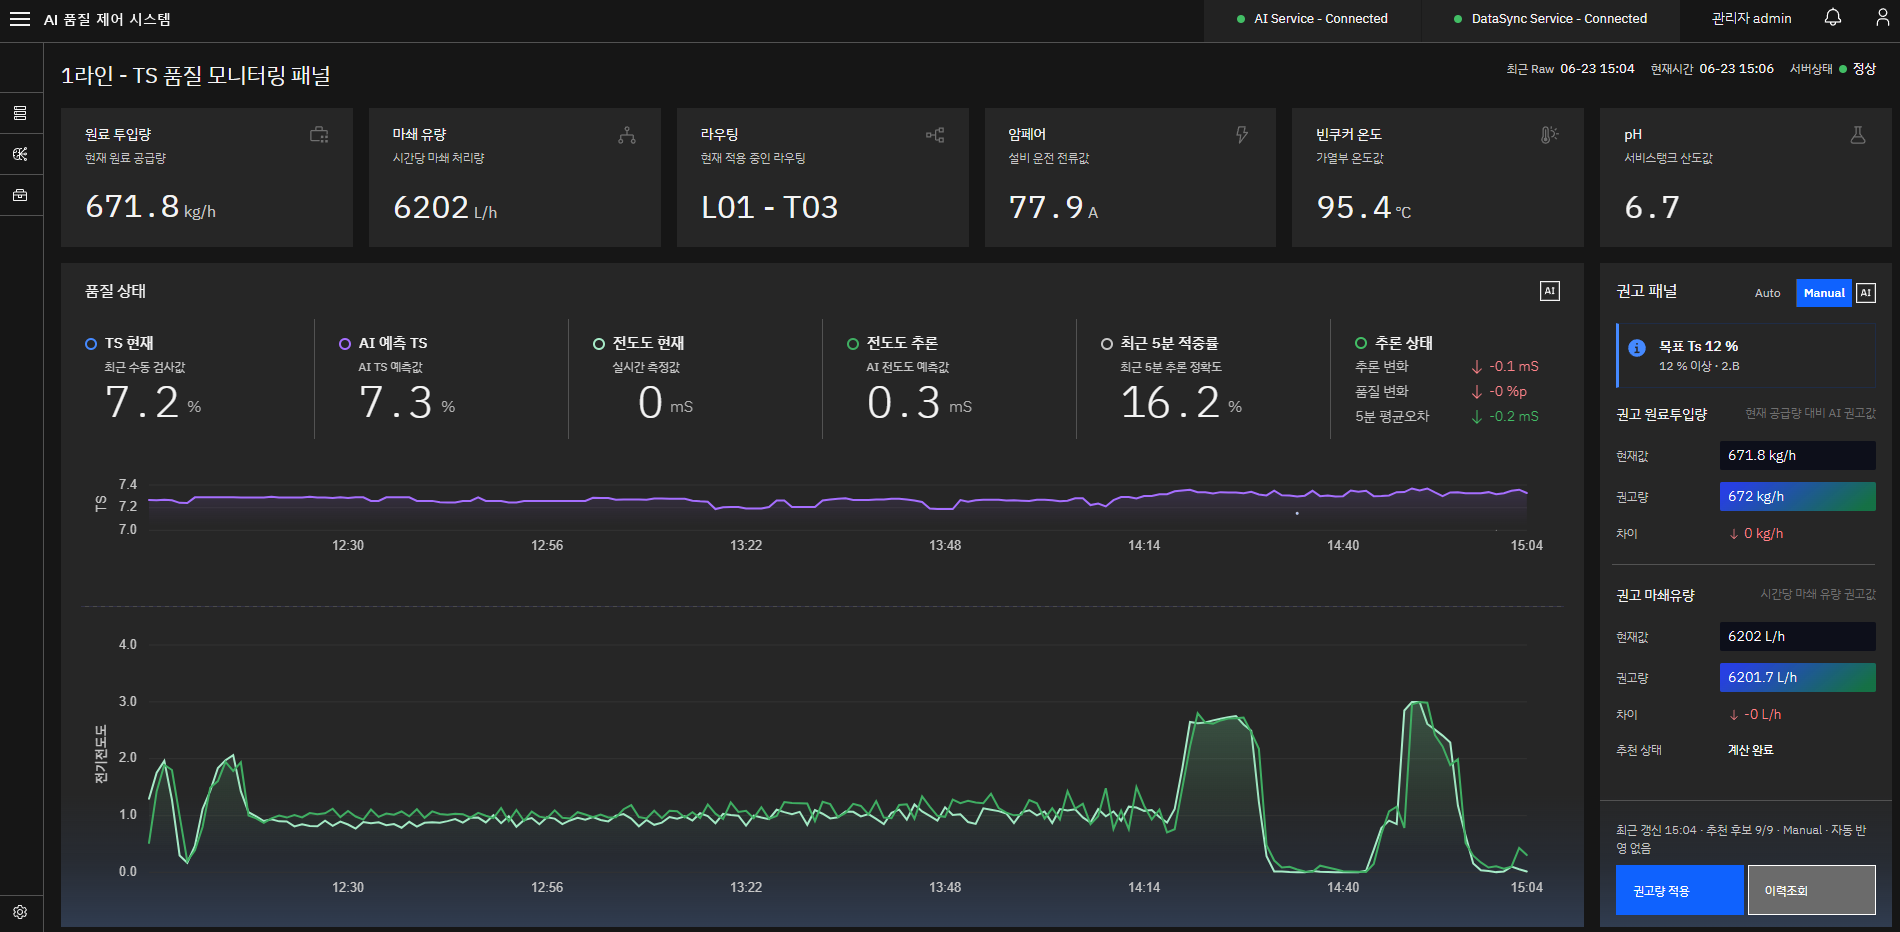
최종 검사를 기다리지 않고 공정 중 값으로 품질을 예측해, 기준을 벗어나기 전에 알립니다.

공정 조건 최적화

원료 상태가 달라도 목표 품질에 맞도록 다음 배치의 투입량과 운전 조건을 권고합니다.

수요 · 판매 예측

지난 판매와 주문 데이터로 품목별 수요를 예측해 생산 계획과 재고 기준을 잡습니다.

설비 고장 예측

정상 운전 패턴을 학습해 평소와 다른 움직임을 점수로 매기고 고장 징후를 먼저 잡습니다.

공정 시뮬레이터

과거 생산 데이터를 다시 흘려 새 조건을 적용했을 때의 결과를 계산합니다. 실제 배치로 하던 시험을 줄입니다.

소재 · 연구 데이터 분석

실험 데이터로 물성과 수명을 예측하고, 사용 조건에 맞는 소재 조합을 추천합니다.

적용 사례

현장에서 예측하고 맞추는 데 쓰고 있습니다

식품 제조 · 음료

배치마다 레시피를 AI가 다시 맞춥니다

과제
같은 레시피로 넣어도 원료 상태가 배치마다 달라 최종 탱크의 품질 지표가 흔들렸습니다. 투입량 보정은 숙련 작업자의 감에 맡겨져 있었습니다.
방법
원료 투입 카운터, 설정·실제 투입 속도, 물 유량, 가열기 온도, 하류 부하 신호를 1분 단위로 정렬하고 작업지시·탱크·품목 정보와 합쳤습니다. 라인 하나에 모델 하나가 아니라 라인·탱크·품목별로 따로 학습하고, 여러 AI 모델을 같은 기준으로 비교해 통과한 모델만 씁니다. 목표 품질을 넣으면 투입량과 운전 조건 후보 3개를 계산합니다.
달라진 점
작업자 화면에 다음 배치의 투입 보정값이 권고로 뜹니다. 권고로 시작해 검증이 끝난 범위부터 자동 반영으로 넘어갑니다.
Analyze · LINKER
식품 제조 · 음료

레시피를 바꾸기 전에 시뮬레이터로 먼저 돌려 봅니다

과제
새 투입 조건을 시험하려면 실제 배치를 써야 해서 원료와 생산 시간이 들었고, 결과가 나쁘면 그 배치는 버려야 했습니다.
방법
과거 생산 데이터를 1분 단위로 다시 흘려 모델이 예측한 품질과 실제 품질을 나란히 놓고 재현성부터 확인합니다. 검증된 모델에 조절 변수를 바꿔 넣어 품질이 어떻게 나왔을지 계산하고, 실시간 데이터로 한 번 더 검증한 뒤에만 현장에 권고합니다.
달라진 점
현장 시험 전에 결과를 먼저 봅니다. 시험할 조건을 좁혀서 들어가니 버리는 배치가 줄어듭니다.
Analyze · LINKER
식품 제조 · 음료

설비가 멈추기 전에 알립니다

과제
핵심 설비가 예고 없이 서면 생산 계획과 품질이 함께 무너졌습니다. 정비는 고장이 난 뒤에야 시작됐습니다.
방법
진동·전류·온도 센서를 연결하고 두 겹으로 감시합니다. 정상 운전 데이터로 센서별 상·하한을 잡아 명백한 위험은 즉시 잡고, AI가 정상 패턴을 학습해 시간에 따라 조금씩 어긋나는 징후를 잡습니다. 경고와 위험 기준을 나누고 오탐·미탐을 현장에서 맞춰 갑니다.
달라진 점
고장 뒤 수리에서 징후를 보고 계획하는 정비로 바뀝니다. 대시보드와 알림으로 정비 담당자가 먼저 움직입니다.
Analyze · LINKER · LinkerFlow
2차전지 소재

수많은 필터 조합, AI가 3가지로 추려 줍니다

과제
고객사마다 사용 조건이 달라, 담당자가 수많은 필터 조합을 하나씩 맞춰 보고 사이즈와 수량을 손으로 계산해야 했습니다.
방법
고객의 사용 조건을 넣으면 AI가 필터 조합 후보 3가지를 추천하고, 필요한 사이즈에 맞춰 규격과 수량을 자동으로 계산합니다. 조합별로 성능이 떨어지기 시작하는 시점도 함께 예측합니다.
달라진 점
조합을 찾고 계산하던 업무가 1/10로 줄었습니다. 영업과 기술 담당자가 같은 근거로 바로 제안합니다.
Analyze · MES
적용 시나리오

다른 제품과 만나면 예측이 업무가 됩니다

필요할 때 제품을 하나씩 더해, 이렇게 넓혀 갑니다.

LINKER + Analyze + 오케스트레이터
  1. LINKER 설비 상태 데이터를 받습니다.
  2. Analyze 이상 구간을 분석합니다.
  3. 오케스트레이터 점검 보고 초안을 만듭니다.
MES + Analyze + TEAMS
  1. MES 생산·검사 기록을 모읍니다.
  2. Analyze 예측값과 검사값을 비교합니다.
  3. TEAMS 담당자가 품질팀에 결과를 공유합니다.
Catalog + Analyze + 오케스트레이터
  1. Catalog 학습 자료와 모델 정보를 등록합니다.
  2. Analyze 사용할 모델을 배치합니다.
  3. 오케스트레이터 AI가 예측 결과를 받습니다.
기존 시스템과 함께

데이터는 있던 자리에 두세요

도입 방식

구축 범위, 사용자 수, 설치 환경에 따라 구성과 비용이 달라집니다. 현재 상황을 알려주시면 적합한 방식을 안내합니다.

도입 문의

설치 환경

온프레미스·클라우드·내부망의 데이터 반출 기준에 맞춰 학습과 호출 위치를 설계합니다.

기존 시스템 연동

MES 생산 기록과 LINKER 설비 값을 학습·평가 자료로 활용합니다.

개방형 표준

모델 호출 인터페이스로 업무 앱과 AI에 예측 결과를 전달합니다.

FAQ

자주 묻는 질문

어떤 데이터가 있어야 하나요?

예측하려는 결과와 그 결과에 영향을 주는 값이 함께 쌓여 있으면 됩니다. MES · ERP 기록, LINKER로 모은 설비 값, 엑셀 데이터까지 그대로 씁니다.

데이터 과학자가 없어도 되나요?

됩니다. 데이터 준비, 모델 비교, 평가, 배포가 화면으로 이어져 있어 현업 담당자가 결과를 보고 고르면 됩니다. 구축 초기에는 웨이브그램이 함께 모델을 만듭니다.

AI 권고를 바로 설비에 넣나요?

권고로 시작합니다. 시뮬레이터와 실시간 검증을 통과한 범위부터 단계적으로 자동 반영합니다.

ChatGPT 같은 생성형 AI와는 무엇이 다른가요?

생성형 AI는 글과 답변을 만들고, Analyze는 우리 회사 데이터로 숫자를 예측하고 최적 조건을 계산합니다. 둘은 ECHO 오케스트레이터에서 함께 씁니다.

예측이 맞는지는 어떻게 압니까?

모델마다 합격 기준(R² 등)을 미리 정하고, 과거 데이터 재현과 실시간 비교로 검증한 모델만 씁니다.

오픈소스를 활용하나요?

아니요. 웨이브그램은 2020년부터 AI 비전과 AI 제품군을 전문으로 개발해 온 회사입니다. 순수하게 자체 기술로 개발하기 때문에 어떤 고객사만의 프로세스에도 맞춰 최적화할 수 있습니다.